Scopri come SIoTRA può trasformare idee in prodotti.
From IoT Data to Analytics Applications: La stessa base — acquisizione, elaborazione, evento, decisione — cambia dominio senza essere ricostruita. Cambiano il modello dati, i KPI, le regole e il linguaggio: la catena resta quella di SIoTRA.
-
Waste Management
 Come SIoTRA lo abilita
Smart Fleet & Route Optimization
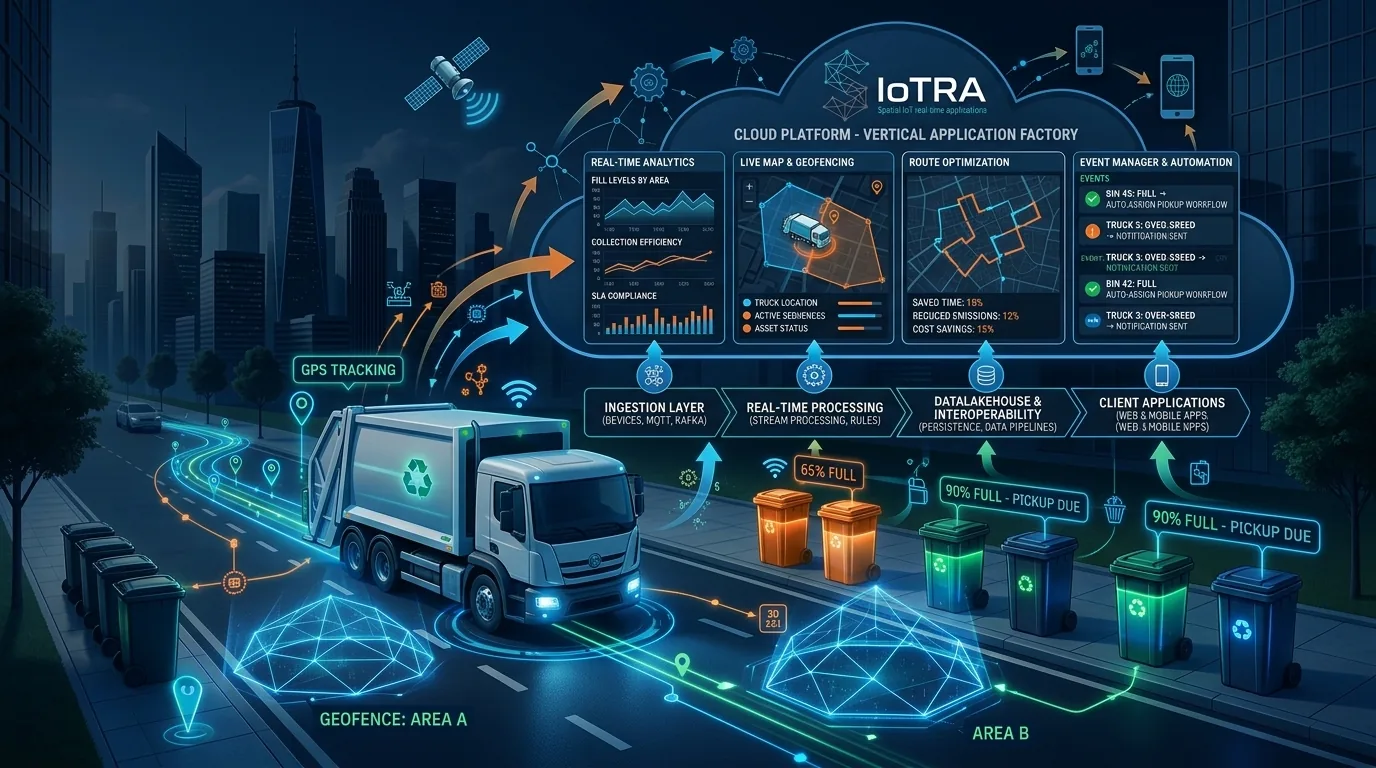
Monitoraggio in tempo reale dei mezzi di raccolta (compattatori, spazzatrici, mezzi RAEE,etc.), con tracciamento GPS, calcolo automatico dei km percorsi per zona, aderenza al giro di raccolta pianificato, rilevazione soste anomale, deviazioni dal percorso, etc.
Come SIoTRA lo abilitaL'Ingestion Layer acquisisce la telemetria dai mezzi, mentre l'Event Processing rileva automaticamente deviazioni di percorso, soste prolungate o mancata copertura di una zona tramite geofencing sui poligoni delle aree di raccolta — tutto configurabile da console senza redeploy quando cambiano le zone o i turni.
Smart Bin Monitoring
Controllo cassonetti intelligenti: sensori di livello di riempimento (ultrasuoni, peso) alimentano un modello che genera allarmi di "cassonetto pieno" o "prossimo al riempimento", ottimizzando la frequenza di svuotamento invece di seguire un calendario fisso.
Come SIoTRA lo abilitaIl motore di Stream Processing calcola misure composite/aggregate a runtime (es. tasso di riempimento nel tempo, previsione soglia critica) e l'Event Manager genera notifiche push/email quando si supera una soglia — collegando direttamente il dato del sensore a un'azione operativa (pianificazione dello svuotamento) senza passare da un report statico.
Dynamic Route Re-Planning basato su eventi
Quando un cassonetto raggiunge la soglia critica, il sistema propone in automatico una ri-pianificazione del giro del mezzo più vicino, invece di aspettare il giro programmato del giorno dopo.
Come SIoTRA lo abilitail valore di soglia è calcolato dal motore e processato dall’Event Manager, al verificarsi della condizione di superamento l’evento generato innesca un workflow di ripianificazione che seleziona il mezzo compatibile in base a posizione live e capacità residua.
Compliance, Tracciabilità e Reportistica ambientale
Ricostruzione dello storico completo del ciclo di vita del rifiuto (raccolta → trasporto → conferimento → trattamento) per audit, reportistica verso enti regolatori e rendicontazione ESG.
Come SIoTRA lo abilitaIl Datalakehouse con persistenza duale (live + storico) rende interrogabile anche a distanza di anni l'intera catena di eventi, e i Data Product Out (DPO) tramite il Data Pipeline Engine permettono di esportare dataset conformi verso enti terzi o sistemi di reporting ambientale.
-
Cold Chain
 Come SIoTRA lo abilita
Real-time monitoring
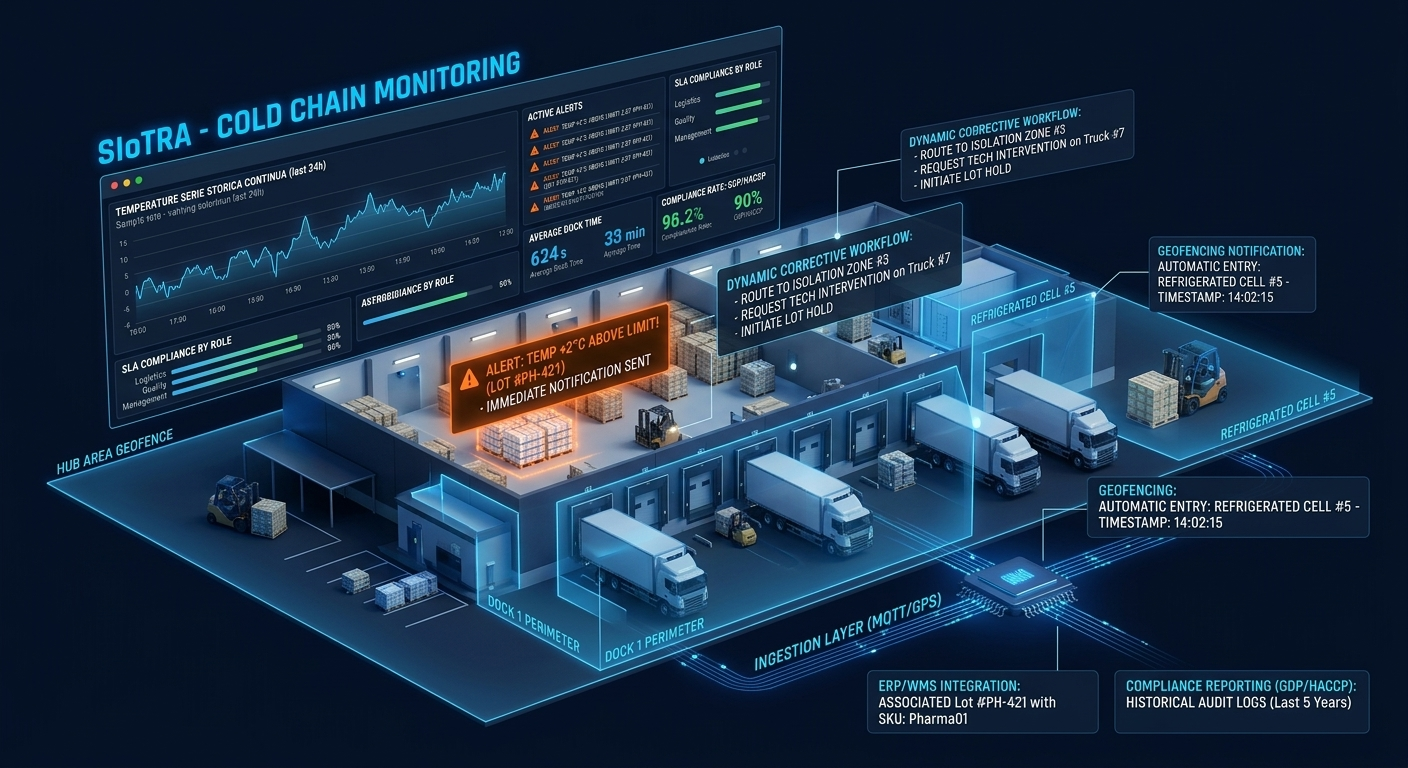
Sensori IoT su mezzi refrigerati, container e pallet registrano temperatura, umidità e (dove serve) apertura porte lungo tutto il tragitto, con serie storica continua con frequenza di campionamento variabile.
Come SIoTRA lo abilitaL'Ingestion Layer acquisisce in streaming da sensoristica MQTT e dispositivi GPS in parallelo, con tolleranza ai guasti — quindi anche se un veicolo perde temporaneamente connettività, il dato viene recuperato e riallineato senza buchi nella catena di custodia del prodotto.
Cold chain breach
Rilevazione in tempo reale superamento soglie critiche (es. +2°C oltre il range consentito per un lotto farmaceutico o alimentare) con notifica immediata a logistica, qualità e cliente, invece di scoprirlo a fine viaggio scaricando il datalogger.
Come SIoTRA lo abilitaLo Stream Processing calcola misure composite a runtime (es. tempo cumulato fuori soglia, non solo il valore istantaneo — spesso il parametro che conta davvero per la shelf-life) e l'Event Manager/Notifier genera allarmi push/email/mobile nel momento stesso in cui si verifica l'evento, permettendo un intervento correttivo (es. deviare il mezzo, isolare il lotto) mentre il trasporto è ancora in corso.
Geofencing su hub, celle frigo e siti cliente
Rilevazione automatica di ingressi/uscite da magazzini refrigerati, hub di transito e punti di consegna, per calcolare tempi di sosta a temperatura controllata vs. non controllata (es. tempo su banchina scoperta).
Come SIoTRA lo abilitaIl motore di geofencing su poligoni complessi, già nativo in Event Processing, permette di distinguere automaticamente "fuori dal frigo ma dentro il perimetro autorizzato" da "fuori rotta/fuori sito", correlando la finestra di esposizione a temperatura con la posizione — cosa che un semplice datalogger isolato non può fare.
Dynamic Corrective Workflow
Alla rottura soglia, il sistema non si limita ad avvisare: propone o attiva un'azione — richiesta di intervento tecnico sul gruppo frigo, blocco automatico del lotto a sistema, notifica al destinatario di un possibile ritardo/scarto.
Come SIoTRA lo abilital'evento a innesca un processo, che può incrociare il dato di temperatura con l'anagrafica lotto/prodotto (via integrazione ERP) per decidere l'azione corretta.
Integrazione con WMS/ERP e tracciabilità del lotto
Collegamento tra il dato ambientale (temperatura/umidità) e l'anagrafica del lotto/SKU/cliente nei sistemi gestionali, così che ogni misura sia associata non solo a "quel veicolo" ma a "quel prodotto, quel cliente, quella scadenza".
Come SIoTRA lo abilitaIl layer di Integrazione dati e API collega ERP, WMS e dispositivi di terzi lasciandoli dove sono, facendo confluire l'anagrafica di prodotto nella stessa catena di elaborazione della telemetria — condizione necessaria per una tracciabilità end-to-end credibile, non solo un log di temperature slegato dal lotto.
Compliance e reportistica normativa
Ricostruzione storica completa e interrogabile della temperatura per ogni spedizione/lotto, a supporto di audit regolatori (Good Distribution Practice per il farmaceutico, HACCP per l'alimentare), con reportistica certificabile su richiesta anche a distanza di anni.
Come SIoTRA lo abilitaIl Datalakehouse con persistenza duale (dati live per l'operatività, storico per analytics/audit) rende ogni spedizione interrogabile a posteriori, mentre i Data Product Out (DPO) via Data Pipeline Engine permettono di esportare report conformi in automatico verso enti certificatori o clienti che lo richiedono contrattualmente.
Dashboard multi-ruolo per KPI di filiera
Cruscotti differenziati per ruolo: logistica (aderenza SLA temperatura per rotta/vettore), qualità (numero e gravità delle rotture soglia per periodo/cliente), management (costo energetico dei gruppi frigo, incidenza scarti da rottura catena del freddo).
Come SIoTRA lo abilitaData Analytics, Report e Dashboard su misura per ruolo sullo stesso insieme di numeri aziendale — così qualità e logistica non lavorano su due versioni diverse della verità, ma sulla stessa pipeline di eventi già validata.
-
Construction Fleet
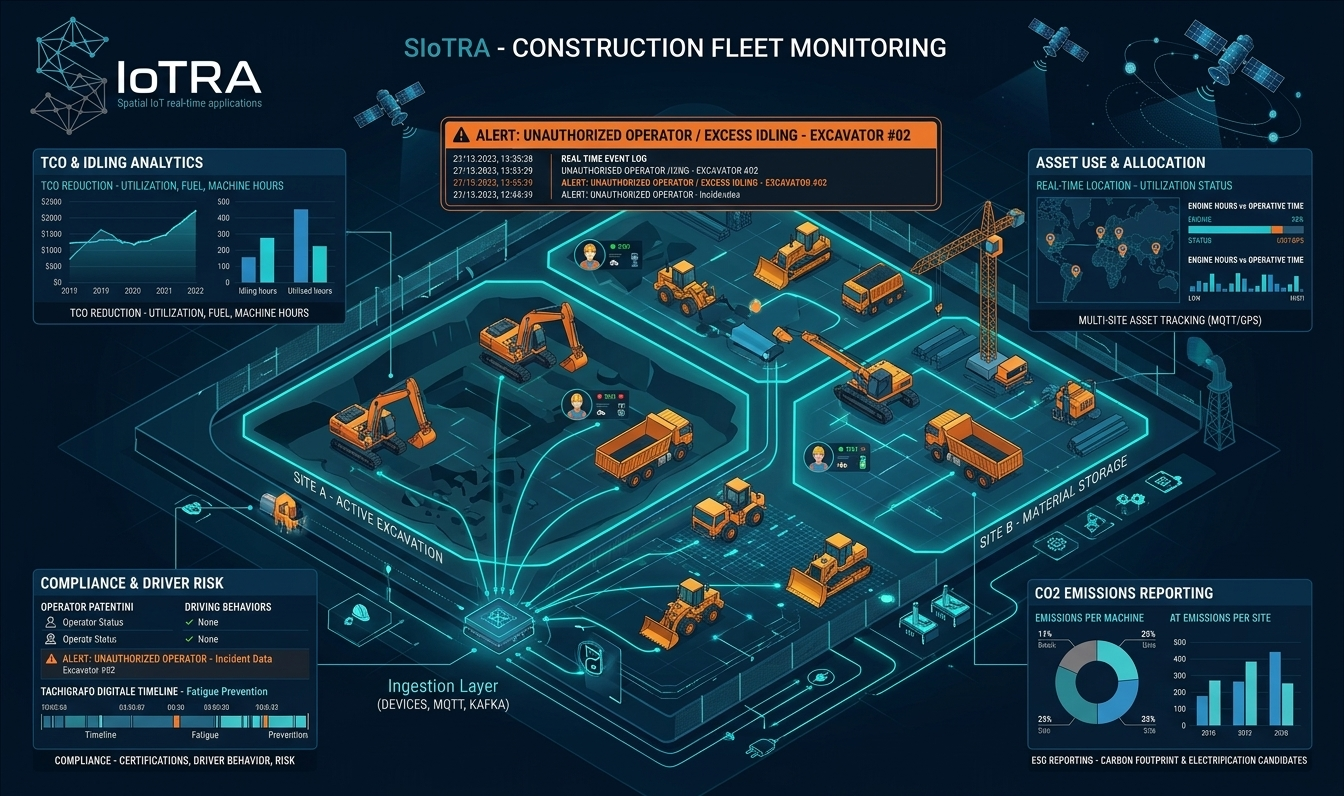 Come SIoTRA lo abilita
Riduzione dei costi (TCO) — utilizzo, carburante, ore macchina
Monitoraggio continuo dell'asset per valutare pattern di utilizzo reale, consumo carburante, tempi di idling e costo totale di possesso per macchina/cantiere, con report e KPI azionabili che permettono di estendere la vita utile del mezzo e contenere i costi di riparazione.
Come SIoTRA lo abilitaLo Stream Processing calcola a runtime misure composite (ore motore vs. ore operative, consumo per ciclo di lavoro, idling anomalo) senza bisogno di redeploy quando cambia la macchina o il cantiere. Questi dati confluiscono nel Datalakehouse, dove Data analytics e dashboard trasformano il flusso grezzo in KPI comparabili nel tempo — la base per decisioni su manutenzione straordinaria, dismissione o riallocazione dell'asset.
Compliance normativa — patentini, formazione, ore di guida
Verifica che l'operatore abilitato corrisponda alla macchina utilizzata, alert automatici su scadenze documentali/formative, monitoraggio ore di guida/operatività per prevenire incidenti da affaticamento (tachigrafo digitale), storicizzazione degli incidenti a fini di audit.
Come SIoTRA lo abilitaL'Integrazione dati e API collega le anagrafiche (patentini, certificazioni, scadenziari) dei sistemi gestionali esistenti, mentre l'Event Processing incrocia in tempo reale "chi sta usando quale mezzo" e genera l'allarme nel momento dell'uso non conforme, non a posteriori su un report. Il Datalakehouse rende l'intero storico interrogabile per un audit anche a distanza di anni.
Sicurezza dell'operatore — comportamento di guida e incident data
Analisi del comportamento di guida/operatività (accelerazioni brusche, eccesso velocità, manovre a rischio) per programmi di coaching e riduzione incidenti, con dati che alimentano anche reportistica assicurativa e comparativa tra operatori/cantieri.
Come SIoTRA lo abilitaIl motore eventi rileva in tempo reale condizioni di rischio (over-speed, manovre anomale, sosta in zona pericolosa) tramite le stesse regole configurabili usate per gli altri allarmi operativi, e il Notifier instrada l'alert a chi deve intervenire (capocantiere, HSE manager). I dati storicizzati nel Datalakehouse diventano la base per il benchmarking tra operatori richiesto da un programma di risk reduction o da una polizza assicurativa.
Visibilità asset — dove si trova, come viene usato, su più cantieri
Localizzazione in tempo reale di tutta la flotta su più cantieri contemporaneamente, con vista dettagliata su quando/dove/come ogni mezzo è operativo, per ottimizzare l'allocazione delle risorse tra siti.
Come SIoTRA lo abilitaL'Ingestion Layer multimodale acquisisce da flotte eterogenee (propri, noleggiati, di terzi) con tolleranza ai guasti, e il Live Data porta questa visibilità in tempo reale sulle Client Applications — un'unica vista su tutti i cantieri, non un sistema per sito. Il geofencing distingue automaticamente in quale cantiere si trova ogni mezzo, dato base per ogni decisione di riallocazione.
Sostenibilità — CO2 reporting ed elettrificazione della flotta
Monitoraggio del consumo carburante e calcolo dell'impronta di carbonio della flotta, identificazione dei mezzi candidati all'elettrificazione in base ai pattern di utilizzo reale, a supporto delle decisioni su integrazione di veicoli elettrici e degli obiettivi di sostenibilità aziendali.
Come SIoTRA lo abilitaLe misure composite calcolate (utilizzo, consumo, ore operative) diventano, riaggregate diversamente, la base per il calcolo delle emissioni per mezzo/cantiere. Il Datalakehouse storicizzato permette di simulare scenari "se questo mezzo fosse elettrico" sui pattern di utilizzo realmente osservati, non su stime — e i Data Product Out possono alimentare direttamente la reportistica ESG aziendale.
-
Asset Rental & Tracking
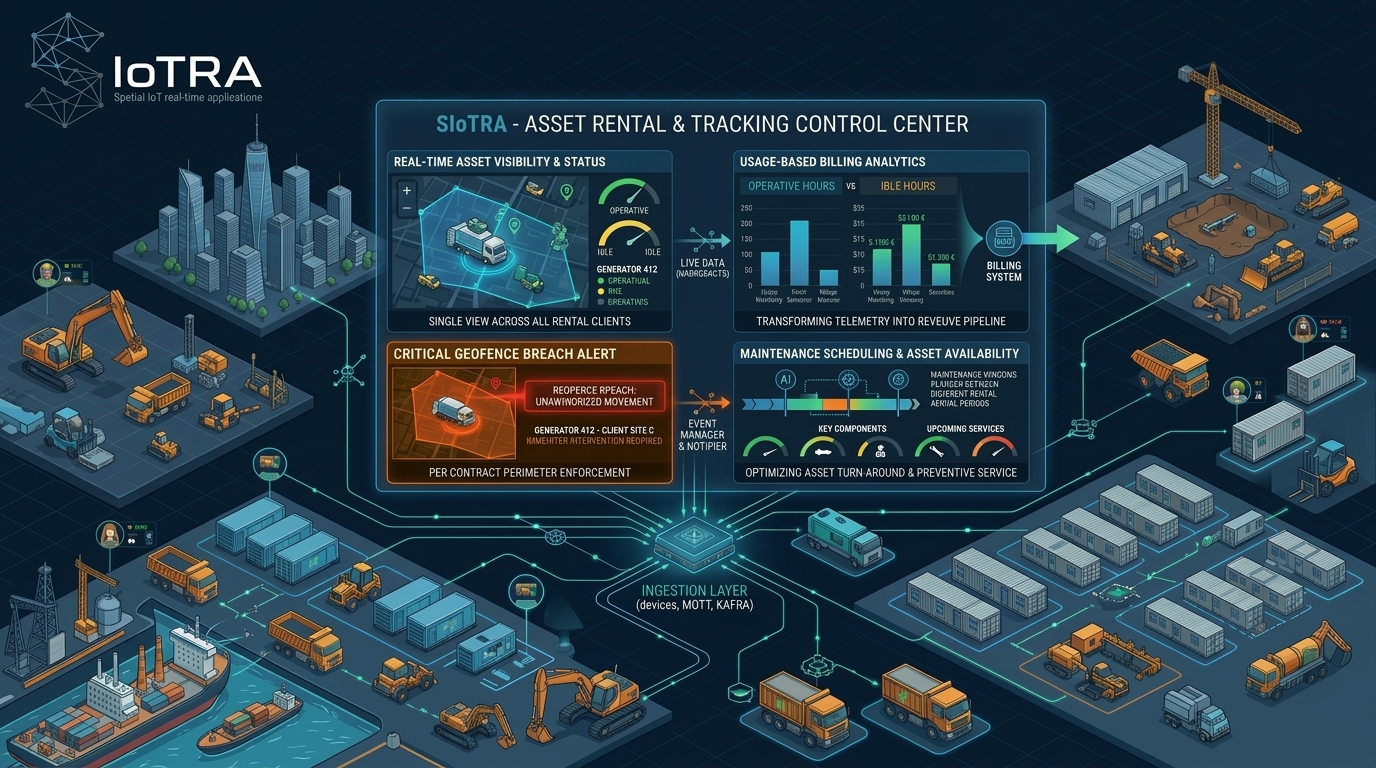 Come SIoTRA lo abilita
Localizzazione e stato asset in tempo reale
Tracciamento continuo di ogni asset a noleggio (mezzi, attrezzature, container, generatori) indipendentemente da dove si trovi — presso il noleggiatore, in transito, presso il cliente — con visibilità su stato operativo, non solo posizione geografica.
Come SIoTRA lo abilitaL'Ingestion Layer multimodale acquisisce da flotte eterogenee di asset con tolleranza ai guasti, e il Live Data rende questa visibilità disponibile in tempo reale sulle Client Applications — un'unica vista sull'intero parco noleggiato, indipendentemente da quale cliente lo stia utilizzando in quel momento.
Usage-based billing
Fatturazione al cliente calcolata su ore/giorni di utilizzo reale dell'asset anziché su una stima forfettaria o sul solo periodo contrattuale, con possibilità di modelli tariffari differenziati (fisso + variabile, pay-per-use).
Come SIoTRA lo abilitaLo Stream Processing calcola a runtime le misure di utilizzo effettivo (ore operative vs. ore di sosta) il dato diventa direttamente un Data Product Out esportabile via Data Pipeline Engine verso il sistema di fatturazione — trasformando la telemetria in un processo di revenue, non solo in un report interno.
Geofencing perimetro d'uso
Verifica automatica che l'asset noleggiato resti nell'area/cantiere/regione prevista dal contratto di noleggio, con alert immediato in caso di spostamento non autorizzato verso un altro sito o, nei casi più gravi, fuori dai confini geografici concordati.
Come SIoTRA lo abilitaIl motore di geofencing configurabile da console per ogni nuovo contratto senza redeploy, permette di definire un perimetro diverso per ogni noleggio attivo e genera eventi di ingresso/uscita dal perimetro in tempo reale — un controllo che nella pratica tradizionale avviene solo a consuntivo, se avviene.
Manutenzione e gestione turn-around noleggio
Monitoraggio di ore/cicli di utilizzo per programmare la manutenzione tra un noleggio e il successivo, garantendo che l'asset venga consegnato al cliente successivo in condizioni ottimali e riducendo i fermi macchina non pianificati durante il periodo di noleggio.
Come SIoTRA lo abilitasoglie di manutenzione configurabili a runtime generano eventi che si integrano col calendario di disponibilità dell'asset: l'AI e automazione dei processi può correlare "ore accumulate dall'ultima manutenzione" con "prossima data di riconsegna prevista" per pianificare l'intervento nella finestra libera più vicina, evitando di bloccare un asset già promesso a un nuovo cliente.
-
Field Service
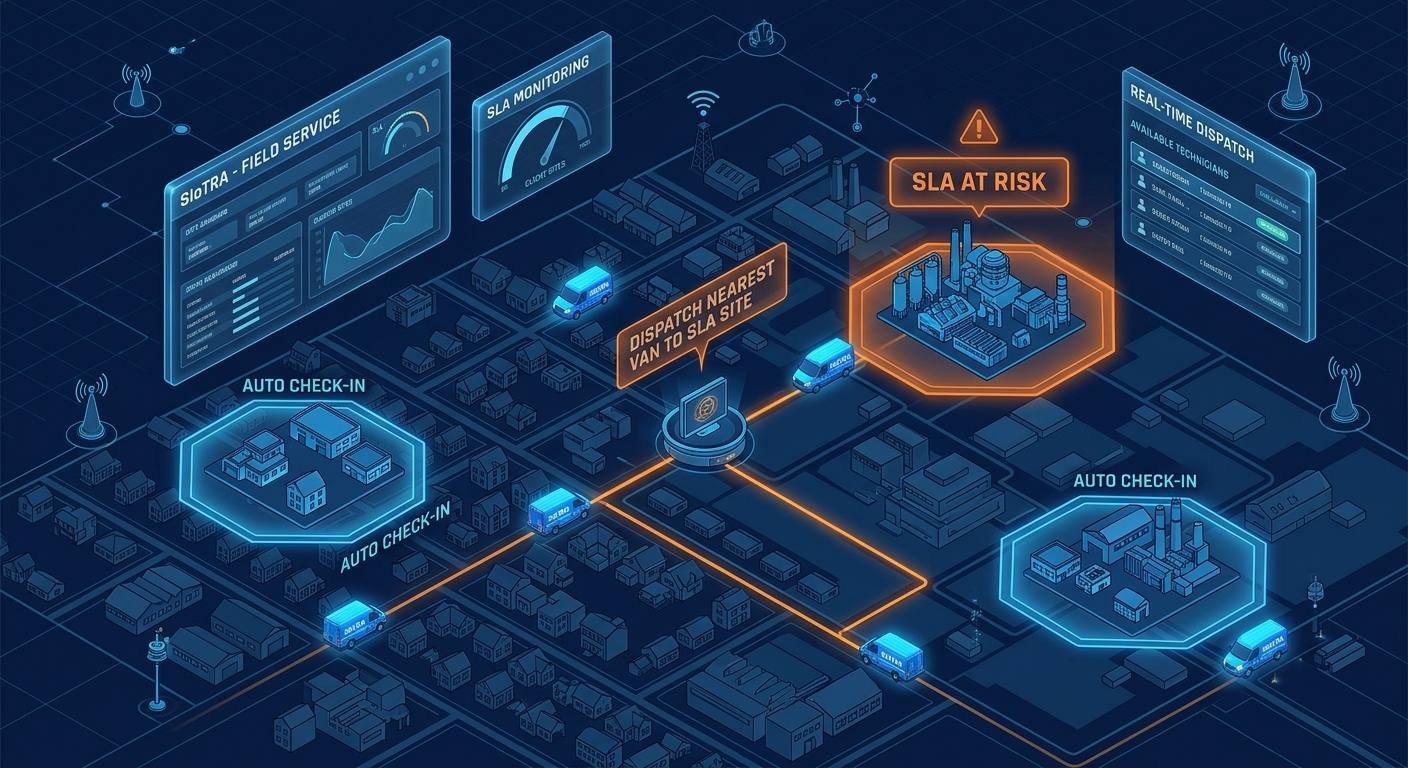 Come SIoTRA lo abilita
Localizzazione tecnici e dispatch intelligente
Visibilità in tempo reale sulla posizione dei tecnici/squadre sul territorio, per assegnare il prossimo intervento al tecnico effettivamente più vicino e disponibile, invece che seguire una turnazione rigida o l'iniziativa del singolo.
Come SIoTRA lo abilitaL'Ingestion Layer acquisisce la posizione da dispositivi (veicolo o app mobile del tecnico) e il Live Data porta questa visibilità in tempo reale sulla Web App di dispatch — la base per un'assegnazione basata su prossimità reale e non su stime.
Geofencing su interventi e siti cliente
Rilevazione automatica di arrivo/partenza del tecnico dal sito di intervento, con calcolo automatico del tempo effettivo speso su ogni commessa/cliente, senza bisogno che il tecnico registri manualmente check-in/check-out.
Come SIoTRA lo abilitaIl motore di geofencing genera l'evento di ingresso/uscita dal sito, che alimenta automaticamente sia il rendiconto ore sia — a valle — la fatturazione dell'intervento, riducendo il lavoro amministrativo manuale e le contestazioni sui tempi dichiarati.
SLA monitoring in tempo reale
Monitoraggio continuo del rispetto degli SLA contrattuali (tempo di risposta, tempo di risoluzione) per intervento/cliente/contratto, con alert automatico quando un intervento rischia di sforare la soglia concordata, mentre è ancora possibile intervenire.
Come SIoTRA lo abilitaLo Stream Processing calcola a runtime la misura composita "tempo trascorso dall'apertura ticket" incrociata con la soglia SLA del contratto specifico, e l'Event Manager genera l'allarme prima dello sforamento (non a consuntivo) — permettendo di riassegnare o scalare l'intervento in tempo utile.
Automazione del workflow di intervento (evento → azione)
Quando un asset presso il cliente (es. impianto, macchinario, contatore) genera un evento di anomalia o guasto, il sistema apre automaticamente un ticket di intervento e lo assegna al tecnico più adatto, senza passare da una segnalazione manuale del cliente.
Come SIoTRA lo abilital'evento non finisce in un report, fa partire un processo: l'anomalia rilevata sull'asset del cliente innesca un workflow in AI e automazione dei processi che genera il ticket e lo instrada — collegando manutenzione predittiva e field service nella stessa pipeline.
Dashboard multi-ruolo per operations e management
Cruscotti differenziati per ruolo: dispatcher (interventi aperti, tecnici disponibili, SLA a rischio in tempo reale), field manager (produttività per tecnico/squadra, tempo medio di risoluzione), direzione (costo per intervento, marginalità per contratto/cliente)
Come SIoTRA lo abilitaData analytics e dashboard con viste su misura per ruolo sullo stesso insieme di numeri validati — dispatcher e direzione lavorano sulla stessa pipeline di eventi, non su fogli separati ricostruiti a mano a fine settimana.
-
Agritech
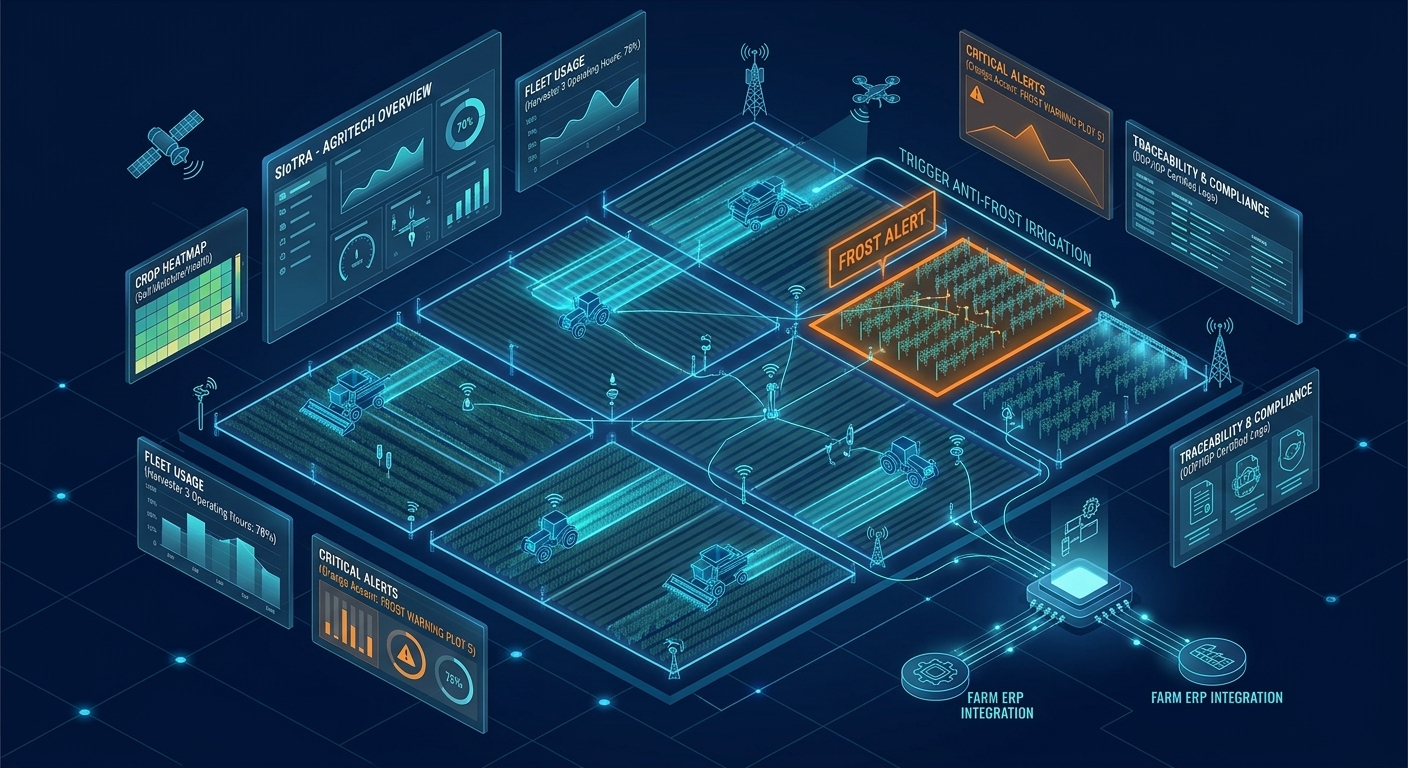 Come SIoTRA lo abilita
Monitoraggio e tracciamento flotte agricole
Localizzazione e monitoraggio utilizzo di trattori, mietitrebbie e altri mezzi agricoli, con calcolo di ore di lavoro effettivo per appezzamento/coltura, consumo carburante e copertura delle lavorazioni pianificate (es. semina completata su tutti gli ettari previsti).
Come SIoTRA lo abilitaIngestion posizione e dati dai mezzi, calcolo misure composite a runtime (ore operative vs. sosta), geofencing sugli appezzamenti per verificare la copertura reale della lavorazione rispetto al piano colturale.
Monitoraggio agronomico distribuito sul campo
Acquisizione continua di dati da sensori distribuiti in campo (umidità del suolo, temperatura, condizioni meteo locali, livello serbatoi/vasche) e da centraline agrometeorologiche, per avere una lettura oggettiva e continua delle condizioni della coltura, non affidata alla sola esperienza dell'agronomo che passa in campo a intervalli.
Come SIoTRA lo abilitaL'Ingestion Layer multimodale acquisisce simultaneamente da sensoristica MQTT distribuita su appezzamenti spesso privi di connettività stabile, con tolleranza ai guasti — condizione essenziale in ambito rurale dove la copertura di rete è discontinua e un buco di dati non deve tradursi in una decisione agronomica sbagliata.
Allarmi su condizioni critiche (gelo, grandine, stress idrico)
Notifica immediata quando le condizioni ambientali rilevate (temperatura in avvicinamento a soglia di gelo, assenza prolungata di pioggia, umidità critica) rischiano di compromettere la coltura, con finestra temporale utile per un intervento di mitigazione (irrigazione antibrina, copertura, trattamento).
Come SIoTRA lo abilitaL'Event Manager e il Notifier distribuiscono l'allarme via push/email/mobile nel momento in cui la soglia viene superata, ogni ora guadagnata tra "condizione critica rilevata" e "agricoltore avvisato" può significare salvare un raccolto.
Tracciabilità del prodotto e compliance (filiera, biologico, PAC)
Ricostruzione storica di trattamenti, irrigazioni, lavorazioni effettuate su ogni appezzamento/lotto, a supporto di certificazioni (biologico, DOP/IGP), supporto alla rendicontazione per la Politica Agricola Comune o richieste di tracciabilità della filiera verso il consumatore finale.
Come SIoTRA lo abilitaIl Datalakehouse con persistenza duale rende ogni appezzamento/lotto interrogabile anche a distanza di anni, mentre i Data Product Out via Data Pipeline Engine permettono di esportare in automatico i dati richiesti da enti certificatori o dalla filiera a valle (distributore, GDO) senza ricostruire manualmente lo storico a ogni richiesta.
Integrazione con sistemi di gestione agronomica e ERP aziendali
Collegamento tra i dati di campo (sensori, mezzi) e i sistemi gestionali già in uso in azienda agricola (piano colturale, magazzino agrofarmaci, contabilità), così che l'evento rilevato sul campo sia automaticamente associato alla coltura, al lotto e al piano di trattamento corretto.
Come SIoTRA lo abilitaIl layer di Integrazione dati e API collega i sistemi gestionali esistenti facendo confluire piano colturale e anagrafica appezzamento nella stessa catena di elaborazione del dato IoT — condizione necessaria perché irrigazione e allarmi siano calcolati sulla coltura giusta e non genericamente sul sensore.
Dashboard multi-ruolo per la conduzione aziendale
Cruscotti differenziati per ruolo: agronomo (stato colturale per appezzamento, allarmi attivi, storico trattamenti), responsabile mezzi (utilizzo flotta, manutenzioni in scadenza), direzione (costo per ettaro/coltura, resa storica, consumo idrico complessivo).
Come SIoTRA lo abilitaData analytics e dashboard con viste su misura per ruolo sullo stesso insieme di dati validati — l'agronomo che decide se irrigare oggi e la direzione che valuta la redditività di fine campagna lavorano sulla stessa pipeline di eventi, non su rilevazioni manuali scollegate.
-
Public Transport
 Come SIoTRA lo abilita
Localizzazione flotta e informazione all'utenza in tempo reale
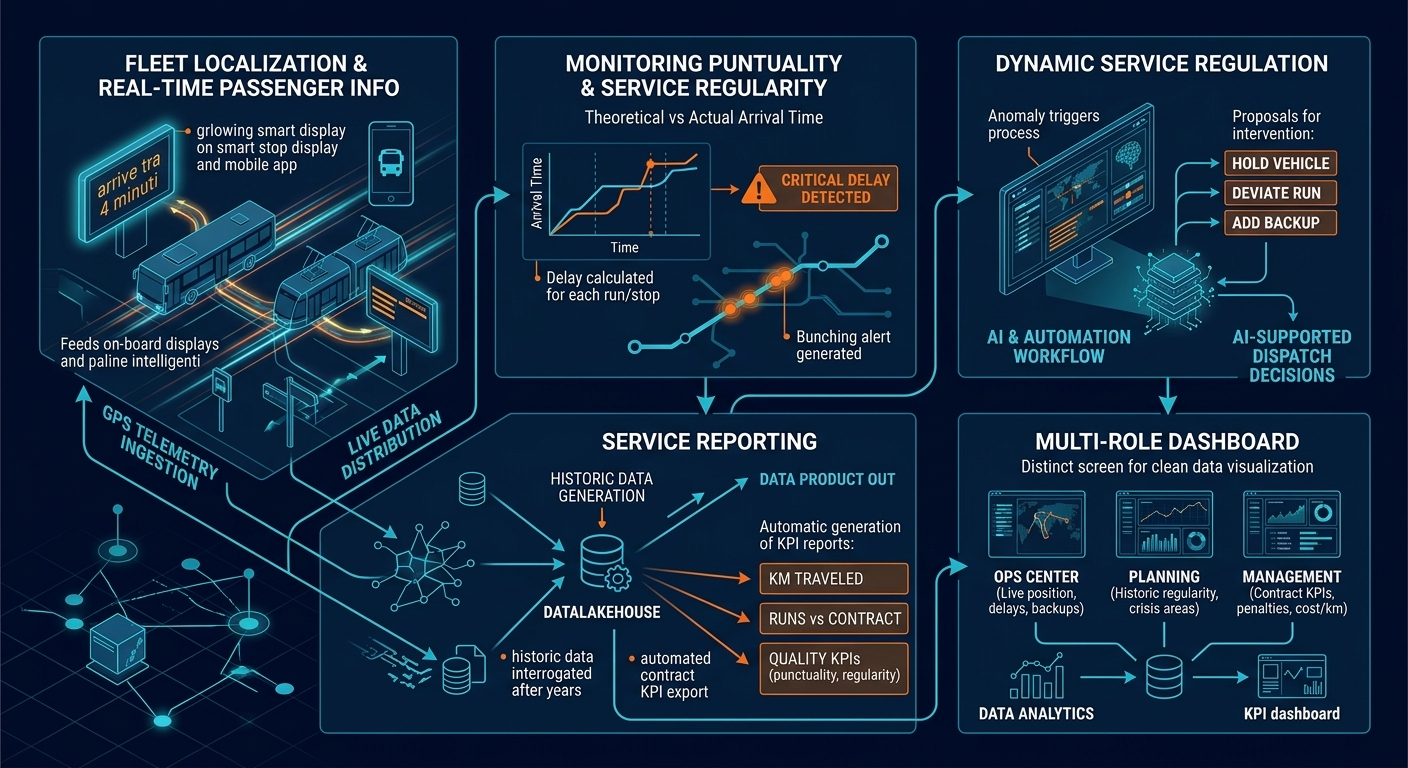
Tracciamento continuo della posizione di ogni mezzo della flotta (bus, tram) con calcolo dello scostamento rispetto all'orario/percorso programmato, per alimentare paline intelligenti, app e display a bordo con l'informazione reale — "il bus arriva tra 4 minuti", non l'orario teorico stampato.
Come SIoTRA lo abilitaL'Ingestion Layer acquisisce telemetria GPS in streaming dall'intera flotta con tolleranza ai guasti, e il Live Data distribuisce la posizione aggiornata alle Client Applications (app cittadino, display paline), rendendo l'informazione all'utenza un valore aggiunto partendo dallo stesso flusso di acquisizione dati usato per il controllo operativo.
Monitoraggio puntualità e regolarità del servizio
Calcolo in tempo reale dello scostamento di ogni corsa rispetto all'orario programmato, rilevazione di intervalli irregolari tra mezzi sulla stessa linea (bunching), con alert quando lo scostamento supera la soglia che genera disservizio percepito dall'utente.
Come SIoTRA lo abilitaLo Stream Processing calcola a runtime la misura composita "ritardo rispetto a orario teorico" per ogni corsa/fermata, e l'Event Processing confronta il dato con soglie configurabili per linea — la puntualità diventa un parametro monitorato con la stessa continuità con cui altrove si monitora una temperatura o un livello di riempimento, solo applicata al tempo invece che a una grandezza fisica.
Regolazione dinamica del servizio
Quando si rileva un bunching o un ritardo critico su una linea, il sistema supporta la centrale operativa con una proposta di intervento — es. trattenere un mezzo in attesa, deviare una corsa, inserire un mezzo di riserva — invece di scoprire il problema quando arrivano le lamentele dei passeggeri.
Come SIoTRA lo abilital'evento non finisce in un report, fa partire un processo: l'anomalia di regolarità rilevata alimenta un workflow di AI e automazione dei processi che supporta la decisione della centrale operativa in tempo reale, non a consuntivo sul report del giorno dopo.
Rendicontazione servizi
Calcolo automatico dei chilometri effettivamente percorsi, delle corse effettuate rispetto al programma di esercizio contrattuale e degli indicatori di qualità del servizio (puntualità, regolarità) richiesti dal contratto di servizio, spesso legati a penali o premi.
Come SIoTRA lo abilitaIl Datalakehouse con persistenza duale rende ogni corsa interrogabile anche a distanza di anni, e i Data Product Out via Data Pipeline Engine permettono di esportare automaticamente i KPI richiesti dal contratto di servizio verso il committente — riducendo il lavoro di ricostruzione manuale a fine periodo e la contestabilità del dato.
Dashboard multi-ruolo per esercizio e direzione
Cruscotti differenziati per ruolo: centrale operativa (posizione flotta in tempo reale, scostamenti attivi, mezzi di riserva disponibili), pianificazione esercizio (regolarità storica per linea/fascia oraria, aree di crisi ricorrente), direzione (KPI contrattuali verso l'ente, penali evitate/subite, costo per km).
Come SIoTRA lo abilitaData analytics e dashboard con viste su misura per ruolo sullo stesso insieme di numeri validati: chi decide in tempo reale in centrale operativa e chi rendiconta a fine trimestre in direzione guardano lo stesso dato, letto con lenti diverse a seconda di cosa deve decidere.
-
Car/Bike Sharing
 Come SIoTRA lo abilita
Localizzazione e stato del veicolo in tempo reale
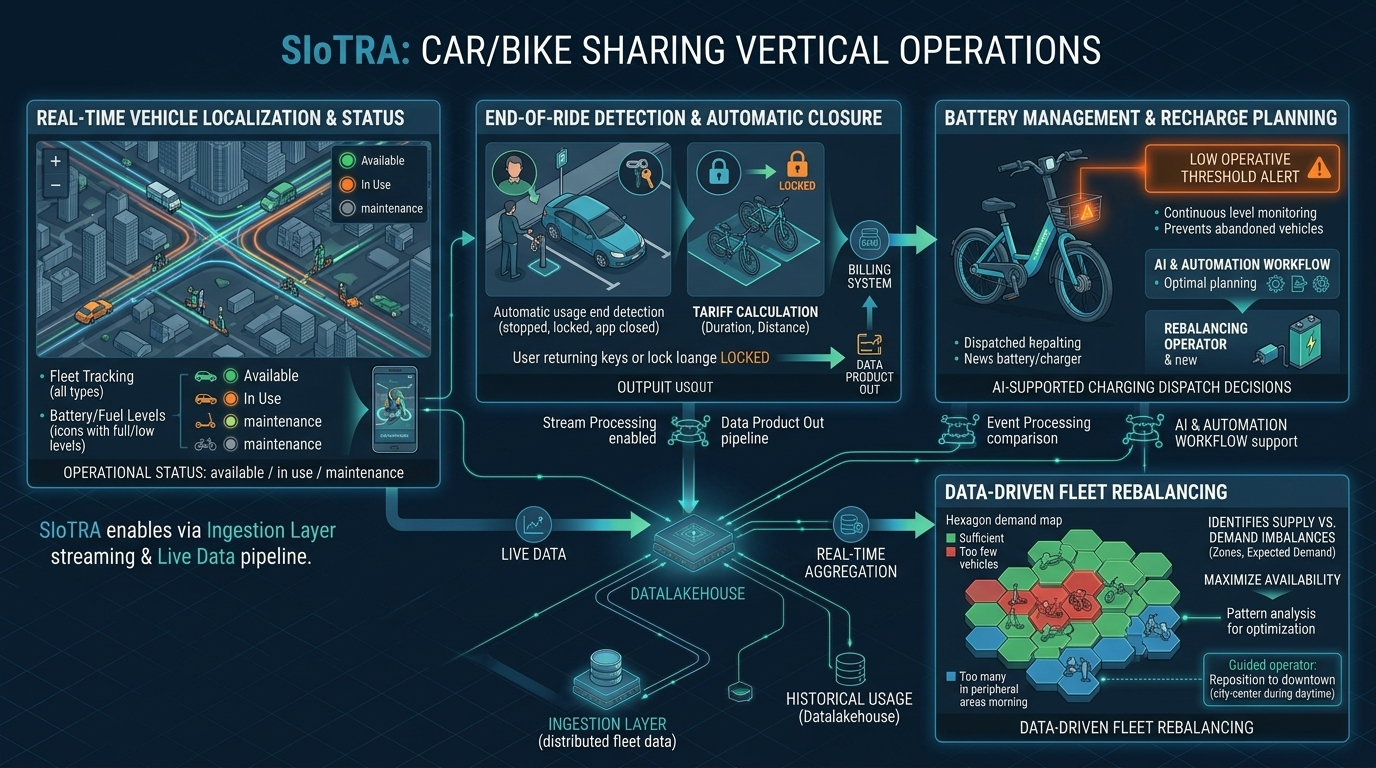
Tracciamento continuo di ogni veicolo della flotta condivisa (auto, e-bike, monopattini) con visibilità su posizione, livello di batteria/carburante e stato operativo (disponibile, in uso, in manutenzione), per alimentare l'app che l'utente consulta per trovare un mezzo vicino.
Come SIoTRA lo abilitaL'Ingestion Layer acquisisce in streaming da una flotta distribuita e spesso numerosa con tolleranza ai guasti, e il Live Data rende questa visibilità disponibile in tempo reale sulle Client Applications — la mappa che l'utente vede nell'app è un riflesso diretto della stessa pipeline che alimenta anche il back-office operativo.
Rilevazione fine corsa e chiusura automatica del noleggio
Riconoscimento automatico della fine dell'utilizzo (veicolo fermo, chiave/lucchetto riposizionato, app chiusa dall'utente) per terminare il noleggio e calcolare la tariffa dovuta, senza intervento manuale da parte dell'operatore.
Come SIoTRA lo abilitaLo Stream Processing calcola a runtime la misura di utilizzo effettivo (inizio-fine corsa, durata, distanza percorsa) e questo dato diventa un Data Product Out verso il sistema di fatturazione.
Gestione batteria e pianificazione della ricarica/sostituzione
Monitoraggio continuo del livello di carica di ogni veicolo elettrico, con allarme quando scende sotto una soglia operativa, per pianificare il recupero e la ricarica prima che il mezzo si scarichi completamente e diventi indisponibile o, peggio venga abbandonato scarico su strada.
Come SIoTRA lo abilitaL'Event Processing confronta il livello di batteria con soglie configurabili per tipologia di veicolo e genera l'evento di ricarica necessaria, che l'AI e automazione dei processi può incrociare con la posizione del veicolo e degli operatori di rebalancing per pianificare il recupero più efficiente — la batteria scarica non è un problema da scoprire sul campo, ma un evento anticipato dal sistema.
Riposizionamento della flotta (rebalancing) guidato dai dati
Identificazione delle zone con eccesso o carenza di veicoli disponibili rispetto alla domanda attesa (es. troppi mezzi in periferia la mattina, nessuno in centro), per guidare gli operatori nel riposizionamento manuale o motorizzato della flotta e massimizzare la disponibilità dove serve.
Come SIoTRA lo abilitaL'aggregazione real-time della posizione e dello stato di tutta la flotta, incrociata con lo storico di utilizzo nel Datalakehouse, permette di costruire pattern di domanda per zona e fascia oraria — trasformando il rebalancing da un'attività basata sull'esperienza dell'operatore a una guidata da dati storici e in tempo reale sulla stessa piattaforma.
Integrazione con sistemi di pagamento e piattaforme MaaS
Collegamento tra il dato di utilizzo del veicolo e i sistemi di pagamento dell'operatore, oltre a eventuali piattaforme di Mobility as a Service cittadine che aggregano più operatori di sharing in un'unica app per l'utente finale.
Come SIoTRA lo abilitaIl layer di Integrazione dati e API collega sistemi esterni facendo confluire il dato di utilizzo nella stessa catena di elaborazione che genera anche gli eventi operativi — l'operatore può partecipare a un'iniziativa MaaS cittadina senza dover riprogettare la propria pipeline dati interna.
SIoTRA può uscire sul mercato con il vostro marchio, come un servizio completamente gestito da noi in qualità di technology provider.